اگر با ابزارهای اپن ایآی (OpenAI) کار کرده باشید یا برنامهای را به API آن متصل کرده باشید، احتمالاً با یک سؤال مهم روبهرو شدهاید: چرا اعتبار دلاری حساب سریعتر از چیزی که انتظار دارید مصرف میشود؟ این موضوع وقتی بیشتر خودش را نشان میدهد که با متنهای طولانی، فایلهای حجیم یا محتوای فارسی کار میکنید.
پاسخ این سؤال به مفهومی به نام «توکن» برمیگردد. توکنها بخشهای کوچکی از متن هستند که مدلهای هوش مصنوعی برای پردازش زبان از آنها استفاده میکنند. OpenAI بهجای شمارش ساده کلمات، حجم ورودی و خروجی را با تعداد توکنها اندازهگیری میکند و هزینه استفاده از API هم بر همین اساس محاسبه میشود.
در این مقاله از زرینپرداخت، بررسی میکنیم توکن در اپن ای آی ای پی آی OpenAI API دقیقاً چیست، نحوه محاسبه توکن در OpenAIچگونه است و چرا یک متن مشابه ممکن است در زبانهای مختلف تعداد توکن متفاوتی داشته باشد. سپس با محدودیتهای پنهان سیستم (مثل سقف ترافیک و حافظه) آشنا میشویم و در نهایت، چند ترفند کاربردی و جذاب را یاد میگیریم تا از این پس، پروژههای خود را با کمترین هزینه و بدون قطعیِ ارتباط پیش ببریم.
توکن ایپیآی (API) چیست و چه کاربردی دارد؟
برای اینکه دو نرمافزار بتوانند با هم کار کنند، به یک پل ارتباطی به نام رابط برنامهنویسی اپلیکیشن یا همان API نیاز دارند. شبیه زمانی که یک برنامه هواشناسی، دمای شهرها را از یک سرور مرکزی دریافت میکند. در سرویسهای هوش مصنوعی هم برای ارسال و دریافت متن، از همین پل ارتباطی (API) استفاده میکنیم.
وقتی متنی را از طریق این رابط (API) برای یک مدل زبانی میفرستید، حجم تبادل اطلاعات باید قابل اندازهگیری باشد. اینجا است که پای توکن (Token) به میان میآید. توکن در واقع واحد شمارش متن برای ماشین است.
مدلهای زبانی متن را مانند ما انسانها کلمهبهکلمه نمیخوانند. آنها برای درک جملات، محتوا را با فرآیندی به نام توکنسازی (Tokenization) به بخشهای کوچکتر تقسیم میکنند. به همین دلیل در این سیستم، یک توکن میتواند یک کلمه کامل، یک سیلاب کوتاه یا حتی یک تکحرف باشد.
در نهایت توکن نقش ارز رایج را در این فضا بازی میکند. تمام هزینههای شما و ظرفیت پردازش سرورها براساس همین واحد محاسبه میشود تا یک استاندارد مشخص برای قیمتگذاری وجود داشته باشد.
توکن اپنایآی (OpenAI) چیست و چگونه کار میکند؟
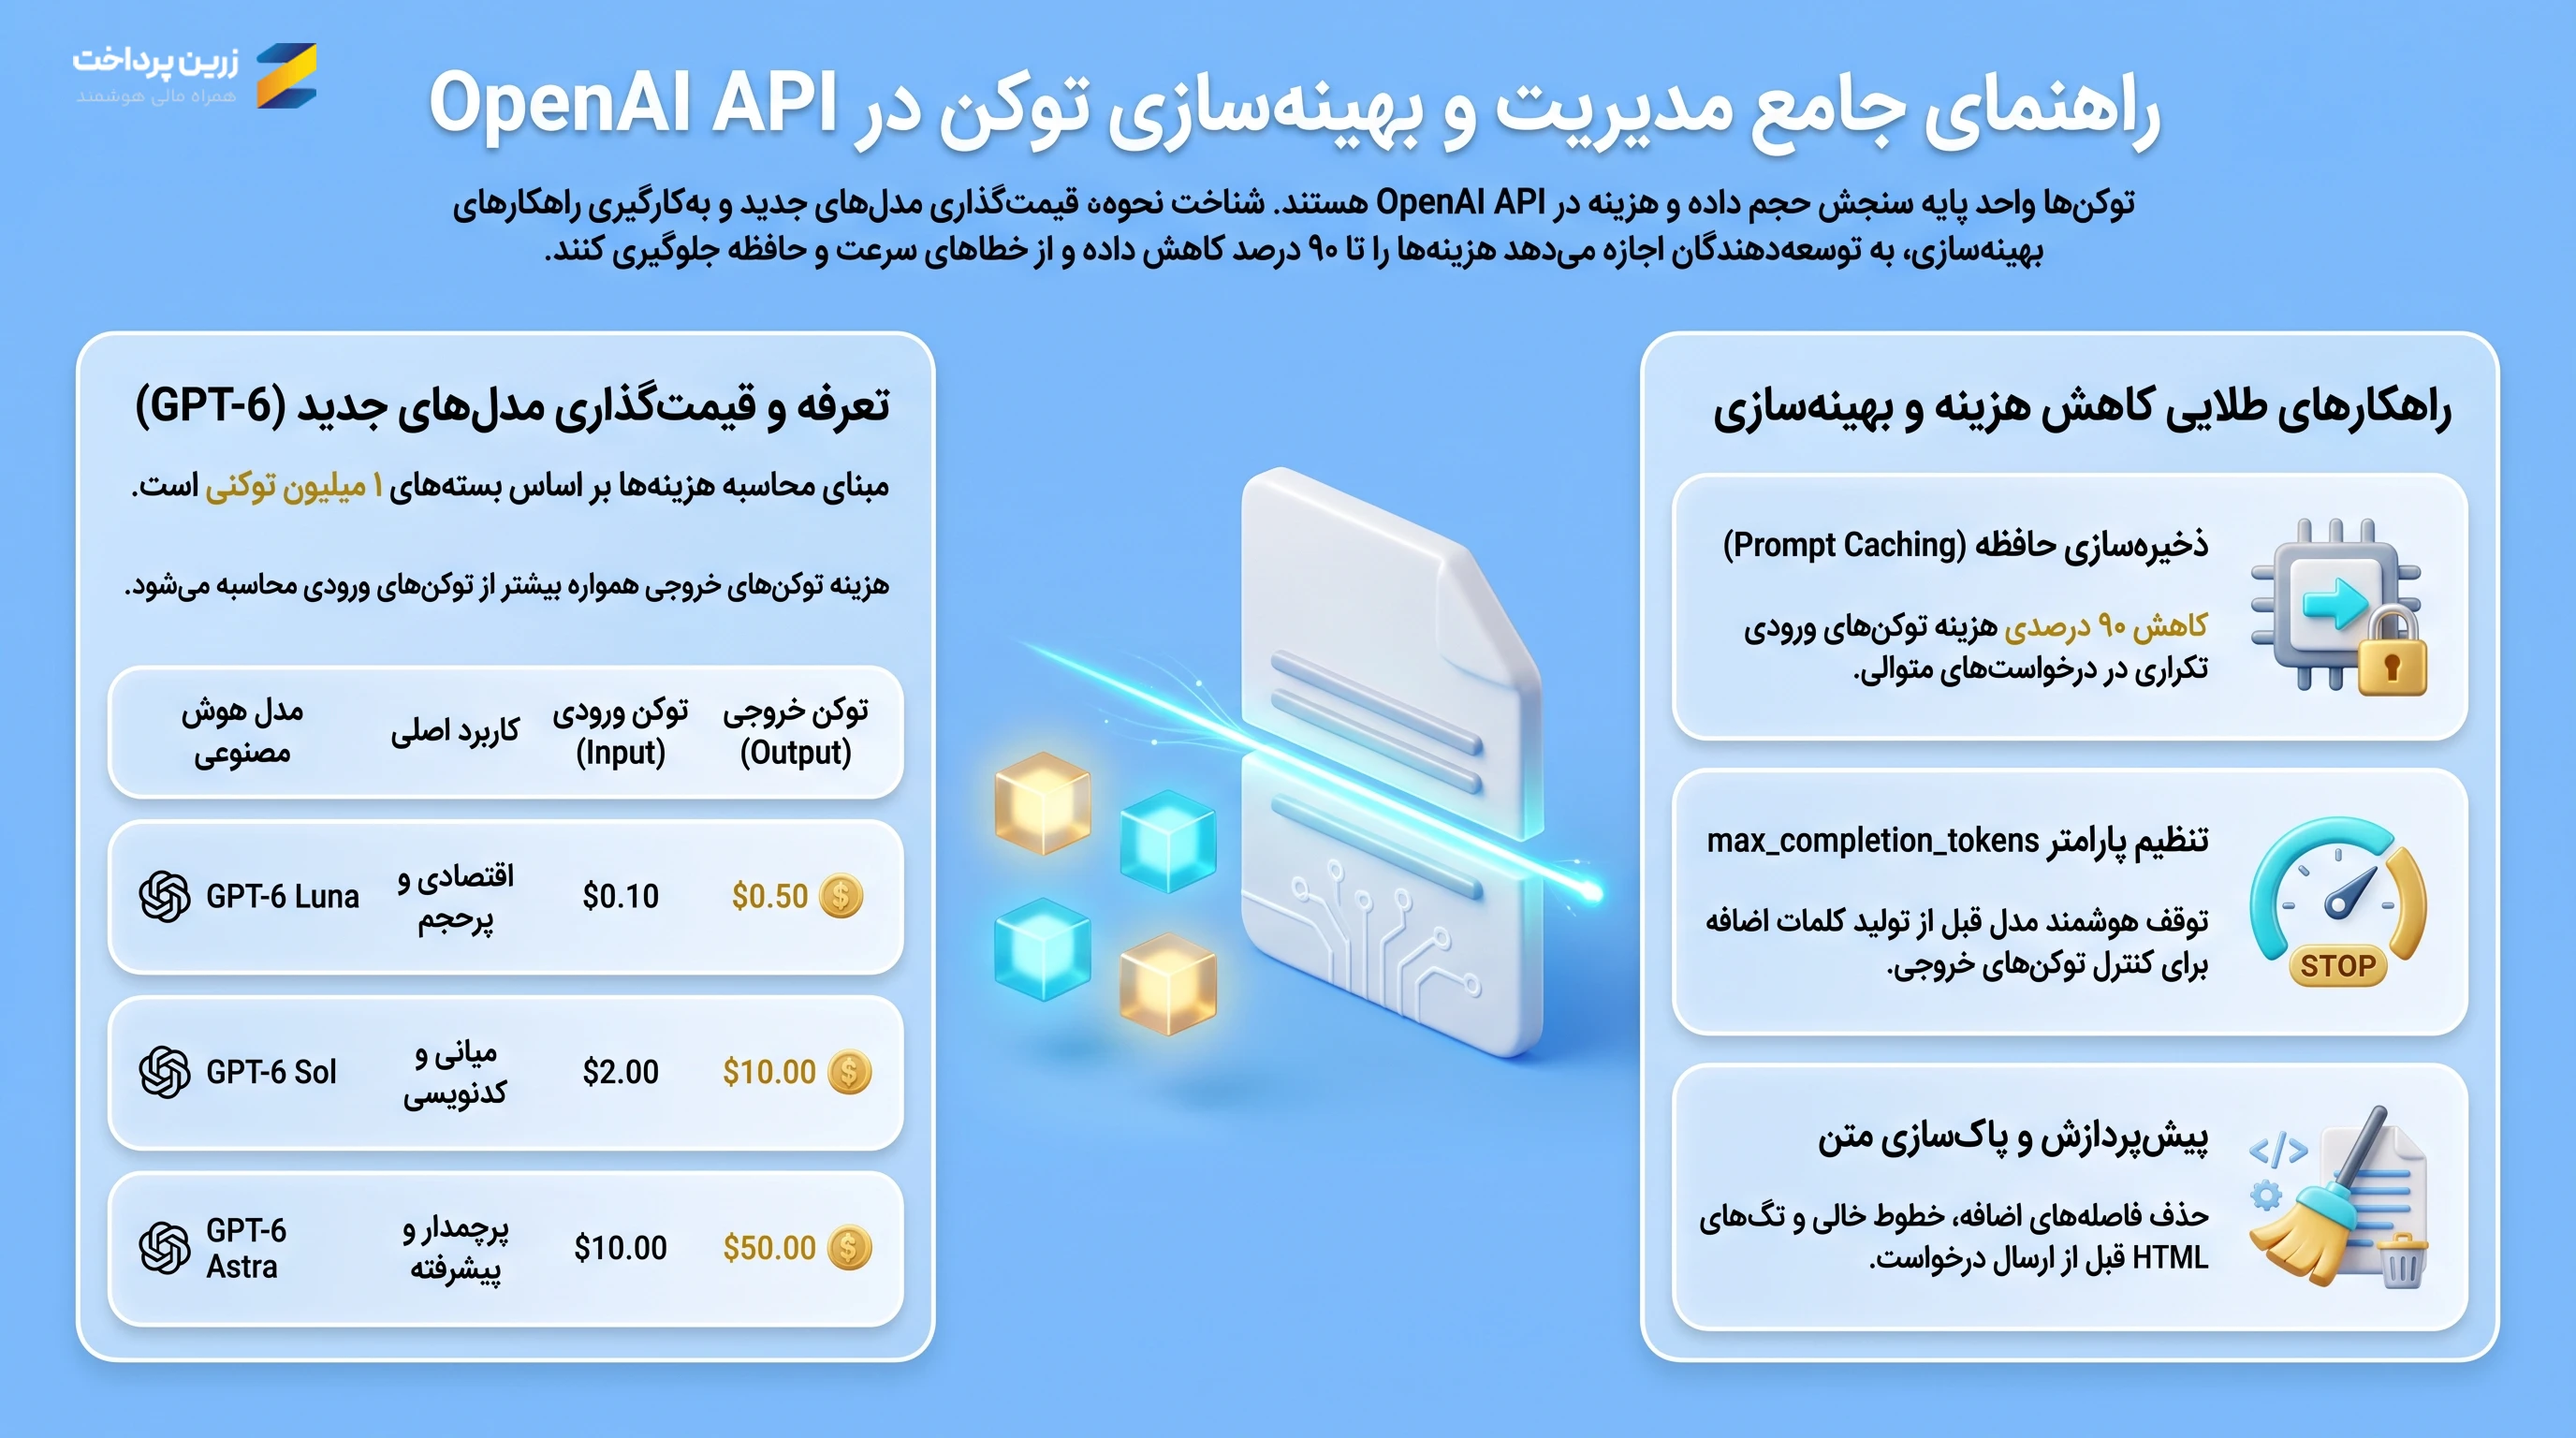
حالا که میدانیم توکن چیست، بیایید ببینیم موتورهای پردازشی در سرویسهای محبوبی مثل چت جیپیتی (ChatGPT) دقیقاً چطور با این قطعات کار میکنند.
در سیستم اختصاصی اپنایآی (OpenAI)، شرکت سازنده ChatGPT، همهچیز بر پایه منطق ریاضی بنا شده است. هنگامی که شما پیامی ارسال میکنید، این سیستم متن را خرد کرده و به هر توکن یک شناسه عددی منحصربهفرد اختصاص میدهد. در واقع، هوش مصنوعی جملات شما را به یک زنجیره از اعداد تبدیل میکند تا بتواند روابط معنایی میان مفاهیم را از طریق محاسبات پیچیده تحلیل کند.
پس از درک این الگوهای عددی، مرحله تولید پاسخ آغاز میشود. سیستم جواب را به صورت یکپارچه و از پیشآماده صادر نمیکند؛ بلکه براساس تحلیل ورودیهای شما، محتملترین توکن بعدی را پیشبینی کرده و به عنوان قطعه بعدی پازل قرار میدهد.
این فرآیندِ تبدیل کلمه به عدد، انجام محاسبه و سپس برگرداندن اعداد به متن، آنقدر سریع تکرار میشود تا خروجی نهایی به صورت یک پاسخ طبیعی و روان به دست شما برسد.
نحوه محاسبه توکن در اپنایآی (OpenAI)
شمارش تعداد توکنها در سیستم اپنایآی (OpenAI) بر اساس دو جریان داده کاملاً مستقل انجام میشود. موتور پردازشی حجم محتوا را به دو دسته توکنهای ورودی (Prompt Tokens) و توکنهای خروجی (Completion Tokens) تقسیم میکند.
توکن ورودی شامل تمام دستورات متنی، تاریخچه مکالمه و فایلهایی است که به سمت سرور میفرستید. در مقابل، توکن خروجی همان متنی است که هوش مصنوعی در پاسخ به شما تولید میکند.
چرا متن فارسی توکن بیشتری مصرف میکند؟
زبانی که با آن مینویسید تاثیر مستقیمی روی تعداد توکنها دارد. برای درک بهتر، وضعیت مصرف توکن در متون فارسی را باید به دو دوره تقسیم کرد:
- در گذشته (مدلهای قدیمیتر مثل GPT-4 و GPT-3.5): به دلیل محدود بودن دایره لغات سیستم، هوش مصنوعی کلمات فارسی را نمیشناخت و مجبور بود آنها را به قطعات بسیار ریزی (گاهی در حد حروف الفبا) بشکند. در آن زمان، پردازش یک متن فارسی 3 تا 5 برابر بیشتر از معادل انگلیسیاش توکن مصرف میکرد که باعث میشد سقف مجاز خیلی زود پر شود.
- وضعیت کنونی (مدلهای جدیدتر از GPT-4o تا GPT-5 و پس از آن): طبق گزارش رسمی اپنایآی، این شرکت با ارتقای چشمگیر الگوریتم شمارش (معرفی o200k_base) و گسترش دایره لغات سیستم، فشردهسازی زبانهای غیرانگلیسی را به شدت بهبود داده است.
در حال حاضر، کلمات فارسی بسیار یکپارچهتر خوانده میشوند. اگرچه یک متن فارسی همچنان حدود 1.5 تا 2 برابر بیشتر از ترجمه انگلیسی همان متن توکن اشغال میکند، اما ارتقای الگوریتم شمارش باعث شده سرعت پردازش بالا برود و هزینه دلاری کار با متون فارسی به طرز چشمگیری کاهش پیدا کند.
ابزارهای شمارش دقیق توکن:
برای مدیریت حجم متن پیش از ارسال درخواست به ایپیآی (API)، دو راهکار استاندارد وجود دارد:
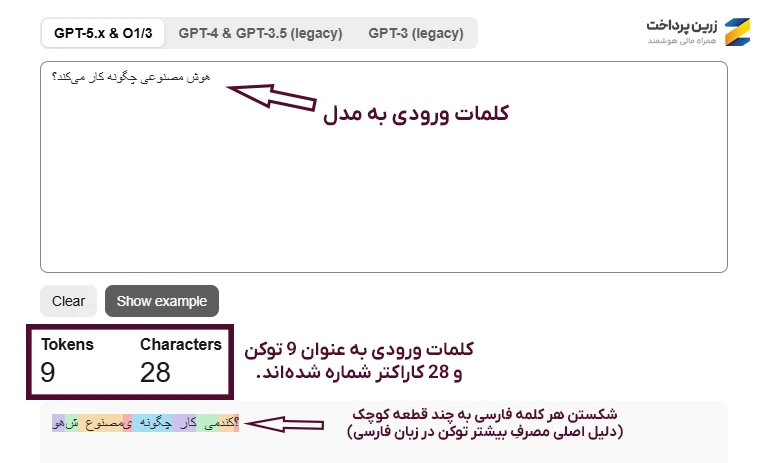
- راهکار تحت وب: با استفاده از ابزار رسمی توکنایزر (Tokenizer) میتوانید متن خود را وارد کنید. این صفحه به صورت بصری و با رنگبندی نشان میدهد جملات شما دقیقاً به چند قطعه شکسته شدهاند.
- راهکار توسعهدهندگان: برنامهنویسها برای محاسبه خودکار میتوانند از پکیج متنباز تیکتوکن (Tiktoken) استفاده کنند. این کتابخانه پایتون اجازه میدهد حجم درخواست پیش از ارسال سمت کاربر محاسبه شود تا از دریافت خطای محدودیت جلوگیری کنید.
قیمت هر توکن اپنایآی (OpenAI) چقدر است؟
شرکت اپنایآی (OpenAI) هیچوقت قیمت را برای یک توکنِ تکی اعلام نمیکند؛ چرا که رقم آن بسیار ناچیز است. در سیستم مالی این شرکت، تمام تعرفهها بر اساس بستههای یک میلیون توکنی (1M Tokens) محاسبه و اعلام میشود.
در این سیستم قیمتگذاری، دو فاکتور اصلی نقش دارند. اول اینکه از کدام مدل هوش مصنوعی استفاده میکنید و دوم اینکه حجم دستورات شما چقدر است. همیشه پردازش توکن ورودی (متنی که شما میفرستید) بسیار ارزانتر از توکن خروجی (متنی که ماشین تولید میکند) تمام میشود.
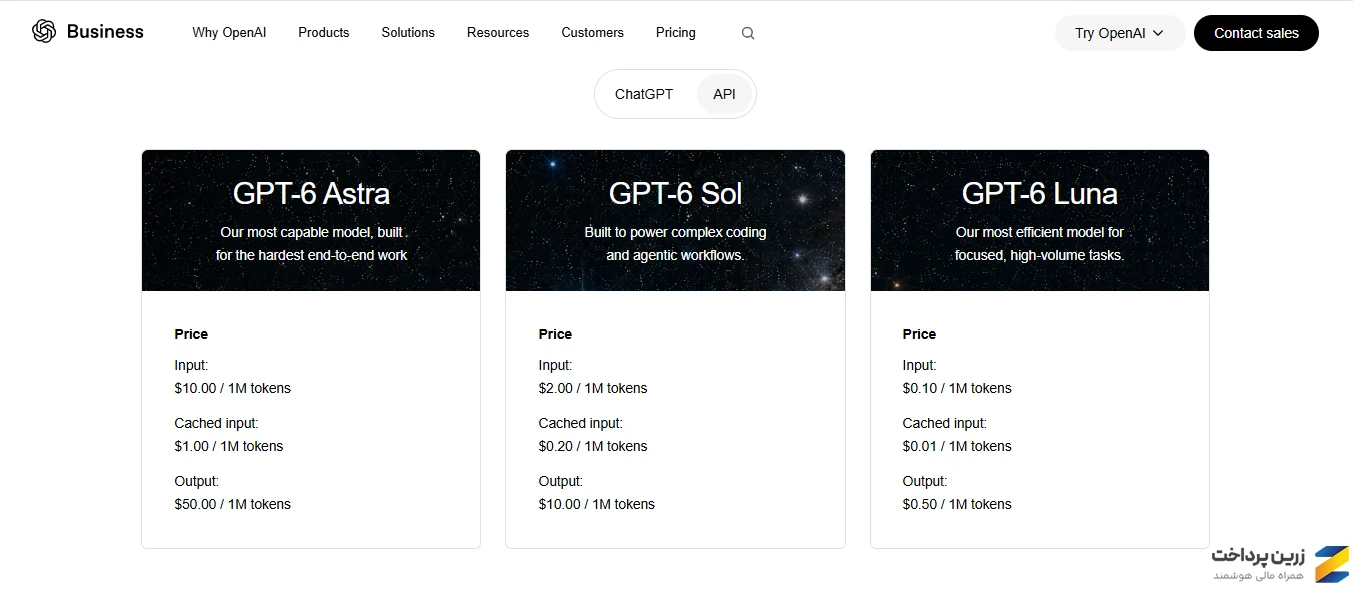
با معرفی خانواده جدید جیپیتی-6 (GPT-6)، سه کلاس قیمتی و کاربردی مشخص برای کاربران تعریف شده است. در جدول زیر، تعرفه رسمی مدلهای اپن ای آی را از اقتصادیترین گزینه تا پرچمدار سیستم برای هر یک میلیون توکن مشاهده میکنید:
| مدل هوش مصنوعی | ردهبندی و کاربرد اصلی | توکن ورودی (Input) | توکن خروجی (Output) |
| GPT-6 Luna | اقتصادیترین: مناسب برای وظایف متمرکز و پرحجم | 0.10 دلار | 0.50 دلار |
| GPT-6 Sol | متعادل و میانی: مناسب برای کدنویسی پیچیده و جریانهای کاری ایجنتها | 2.00 دلار | 10.00 دلار |
| GPT-6 Astra | پرچمدار و گرانقیمت: توانمندترین مدل برای سختترین وظایف سرتاسری | 10.00 دلار | 50.00 دلار |
نکته طلایی درباره کش شدن (Prompt Caching): اپن ای آی قابلیتی برای ذخیره ورودیهای تکراری دارد. اگر یک دستور طولانی را در درخواستهای متوالی تکرار کنید، سیستم آن را در حافظه موقت نگه میدارد و هزینه توکنهای ورودی شما را تا 90 درصد کاهش میدهد.
هزینه استفاده از OpenAI API چطور محاسبه میشود؟
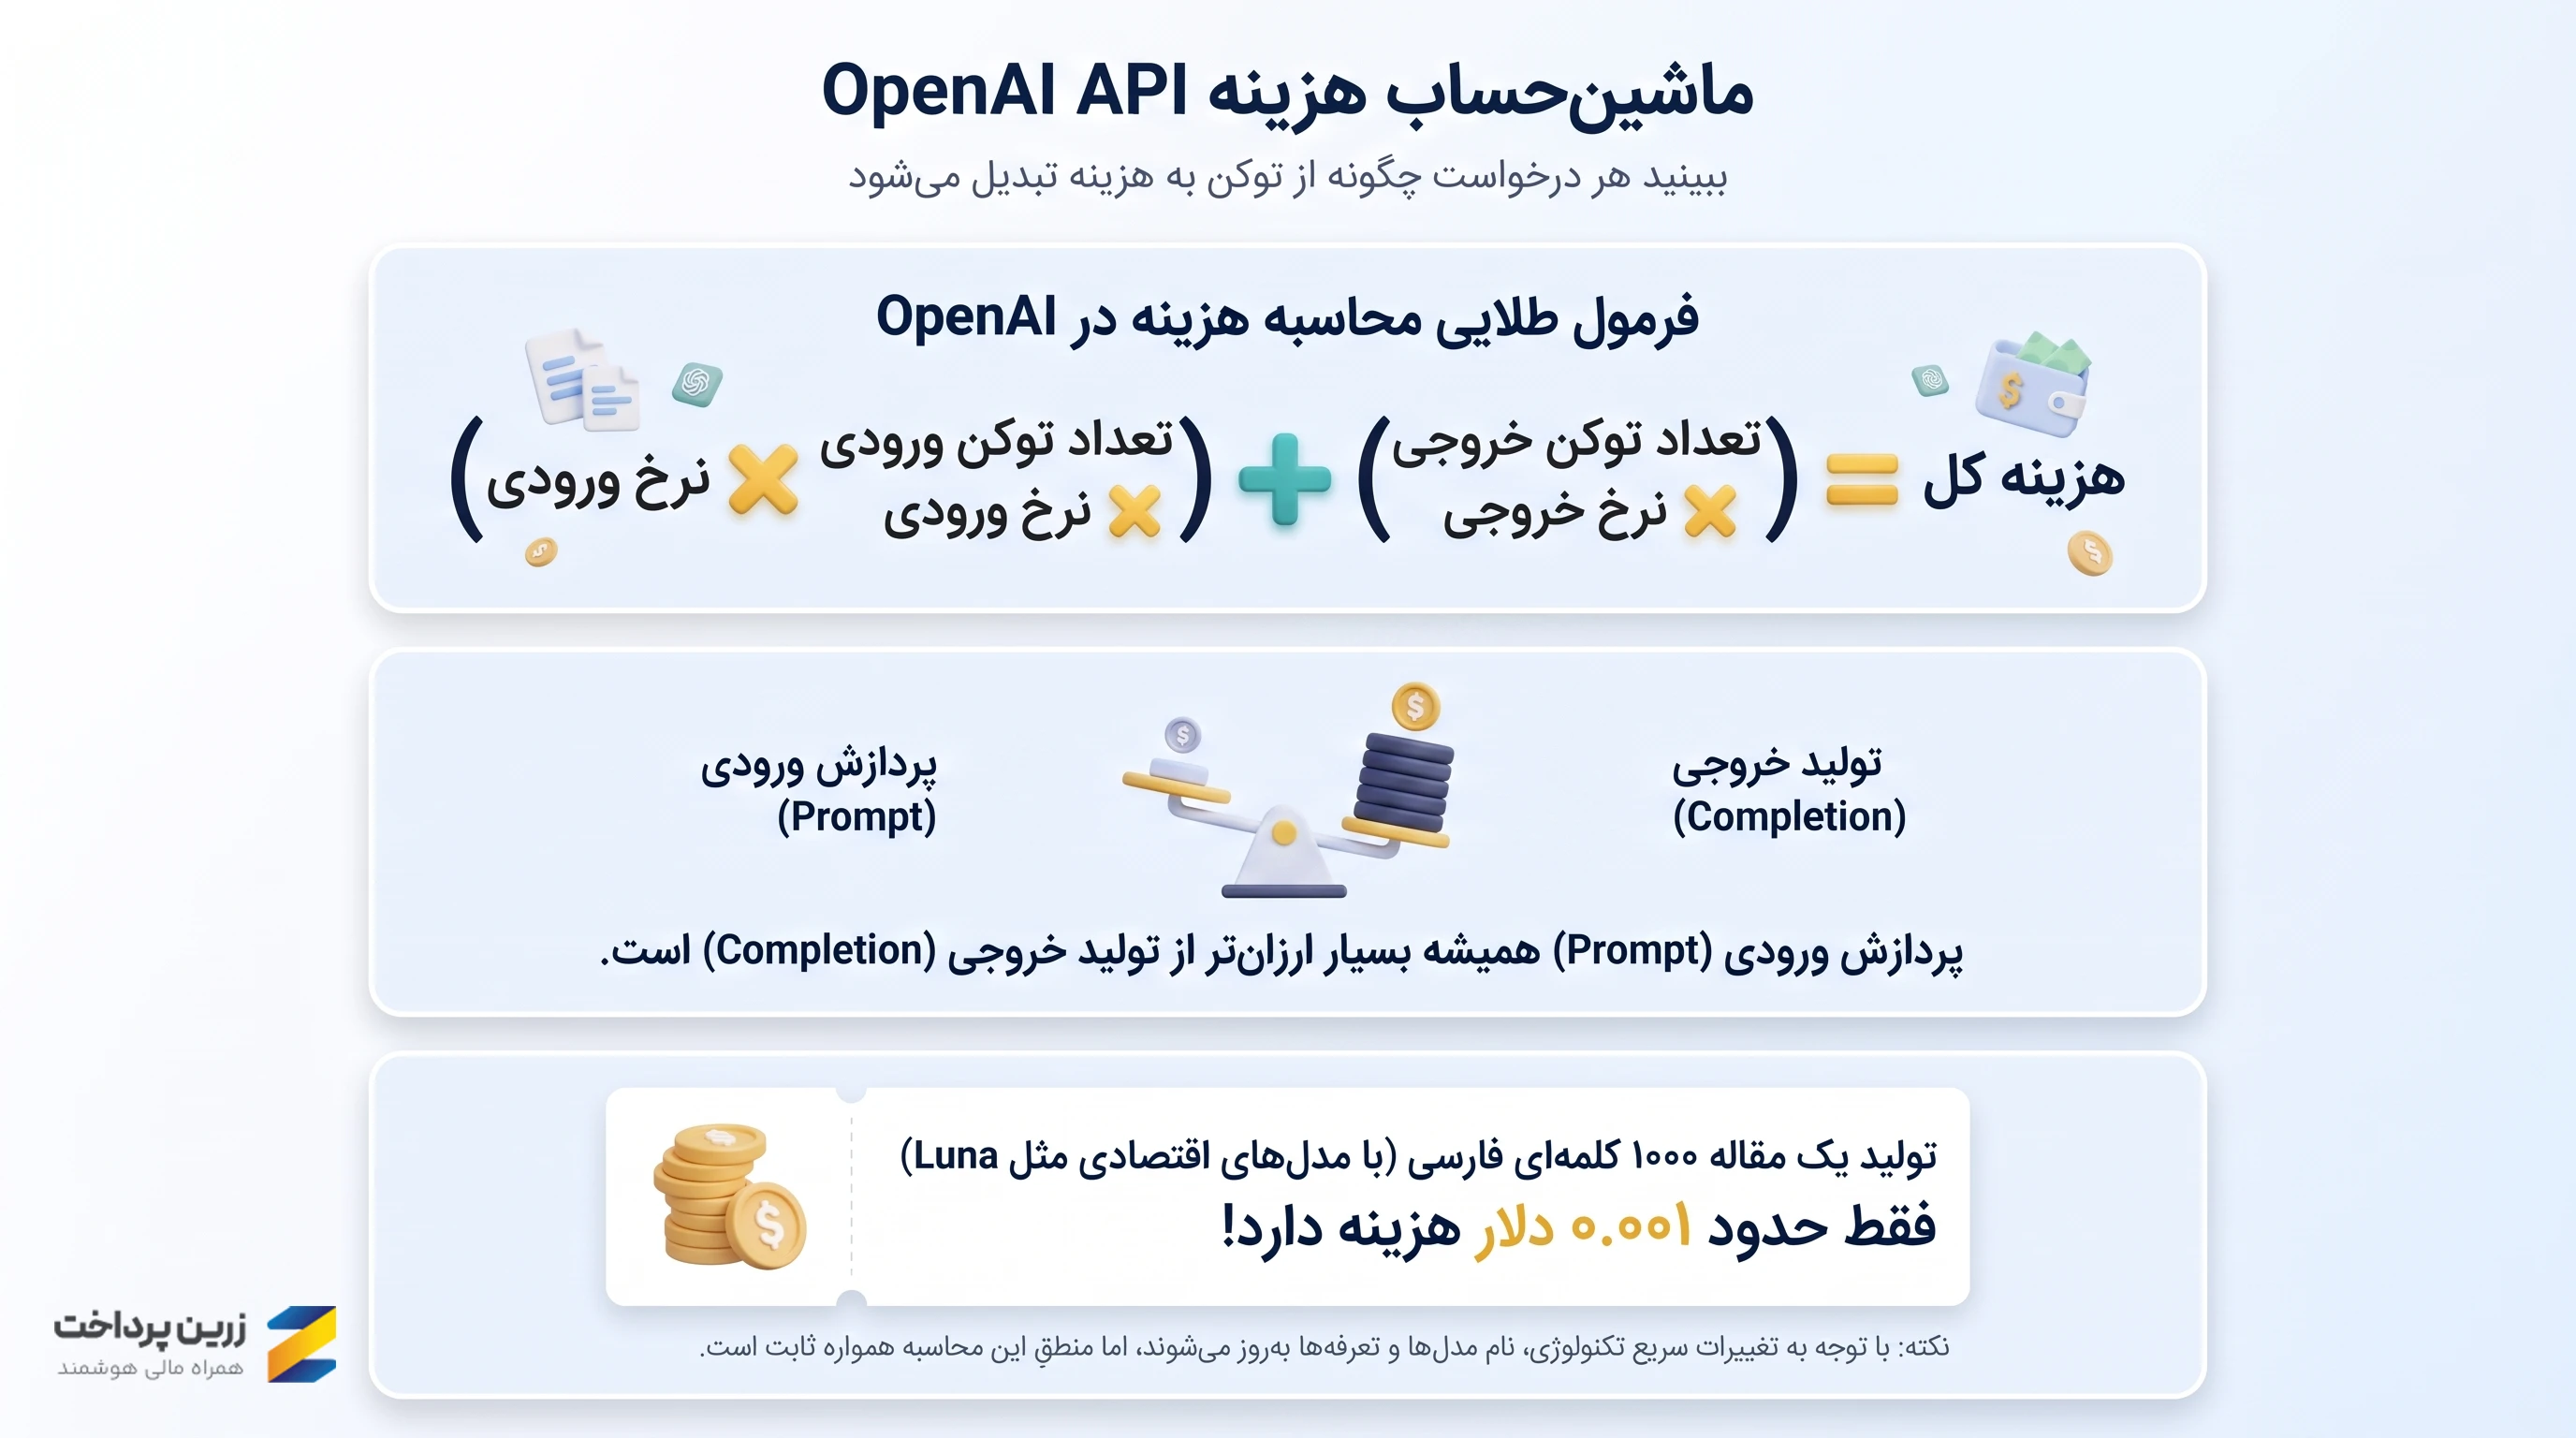
فرمول محاسبه هزینهها در اپنایآی یک ضرب و جمع بسیار ساده است:
برای درک بهتر، یک سناریوی واقعی را با اقتصادیترین مدل فعلی (GPT-6 Luna) بررسی میکنیم:
فرض کنید میخواهید یک مقاله 1000 کلمهای فارسی بنویسید. با در نظر گرفتن ضریب تبدیل زبان فارسی، شما به حدود 200 توکن ورودی (پرامپت) و 2000 توکن خروجی (متن مقاله) نیاز دارید.
اگر این اعداد را با تعرفههای مدل لونا در فرمول بالا قرار دهیم، هزینه ساخت این مقاله تنها 0.001 دلار (حدود یکدهم سنت) تمام میشود!
این محاسبه سریع نشان میدهد که با انتخاب مدل مناسب، استفاده از رابط برنامهنویسی برای تولید محتوای انبوه تا چه حد ارزان و مقرونبهصرفه است.
بررسی محدودیت توکن اپنایآی (OpenAI)
محدودیتهای سیستم اپنایآی یکپارچه نیستند و برای مدیریت بهتر منابع، به دو دسته کاملاً متفاوت تقسیم شدهاند: محدودیت در حافظه در دسترس و محدودیت نرخ درخواستها. شناخت این دو محدودیت برای جلوگیری از توقف کدهای شما بسیار حیاتی است.
حافظه در دسترس (Context Window)
این معیار مشخص میکند که مدل هوش مصنوعی در یک مکالمه واحد، چقدر اطلاعات را میتواند به طور همزمان در حافظه کوتاه مدت خود نگه دارد و پردازش کند.
طبق مستندات رسمی OpenAI، ظرفیت ورودی در مدلهای نسل جدید مانند خانواده GPT-6 (GPT-6 Astra, Sol, Luna) به عدد شگفتانگیز 1.05 میلیون توکن (تقریباً معادل آپلود چندین جلد کتاب قطور یا کل کدهای یک نرمافزار به صورت یکجا) رسیده است. اما نکته کلیدی که بسیاری از کاربران نمیدانند این است که سقف توکنهای خروجی همیشه بسیار محدودتر است.
به عنوان مثال، این مدلها با وجود دریافت چنین ورودی عظیمی، در هر پاسخ حداکثر میتوانند 128 هزار توکن خروجی تولید کنند. این تفکیک ظرفیت به صورت هدفمند طراحی شده است تا از فشار یکباره به سرورها جلوگیری شود. بنابراین برای دریافت خروجیهای بسیار طولانیتر از این سقف، برنامهنویسان باید درخواستهای خود را قطعهبندی کنند.
محدودسازی نرخ درخواستها (Rate Limit)
این محدودیت برای جلوگیری از فشار بیش از حد به سرورها طراحی شده است و سرعت ارتباط شما با رابط برنامهنویسی را کنترل میکند. سقف ترافیک بر اساس دو معیار اصلی سنجیده میشود:
- تعداد درخواست در دقیقه (RPM - Requests Per Minute): حداکثر پیامی که در 60 ثانیه میتوانید ارسال کنید.
- تعداد توکن در دقیقه (TPM - Tokens Per Minute): حداکثر حجم توکنهای مصرفی (مجموع ورودی و خروجی) در یک دقیقه.
بنابراین، اگر نرمافزار یا افزونه شما در کمتر از یک دقیقه درخواستهایی بیشتر از این سقف مجاز به سمت سرور بفرستد، سیستم برای محافظت از خود ارتباط را موقتاً مسدود کرده و خطای معروف 429 (429 Too Many Requests) را برمیگرداند.
راهکار افزایش سقف ترافیک چیست؟
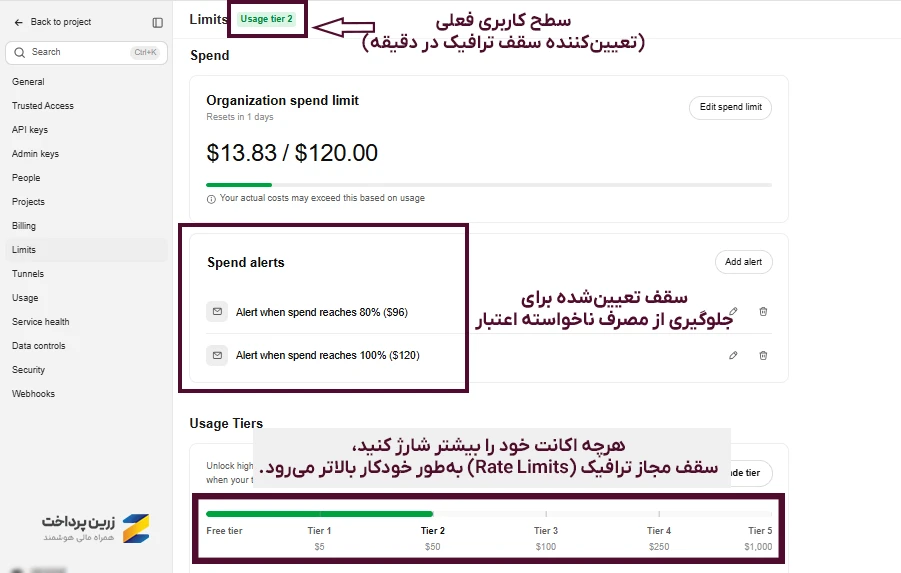
محدودیتهای ترافیکی برای تمام کاربران یکسان نیست. اپن ای آی حسابهای کاربری را بر اساس مجموع پرداختیهایشان سطحبندی (Usage Tiers) میکند. به عنوان مثال، یک اکانت تازه کار (Tier 1) محدودیتهای سختگیرانهای دارد، اما با شارژ بیشتر حساب و رسیدن به سطحهای بالاتر (مثل Tier 5)، سقف ترافیک شما به دهها میلیون توکن در دقیقه افزایش مییابد و مشکل محدودیت سرعت به طور کامل حل میشود.
مصرف توکن در ChatGPT API را چگونه بهینه کنیم؟
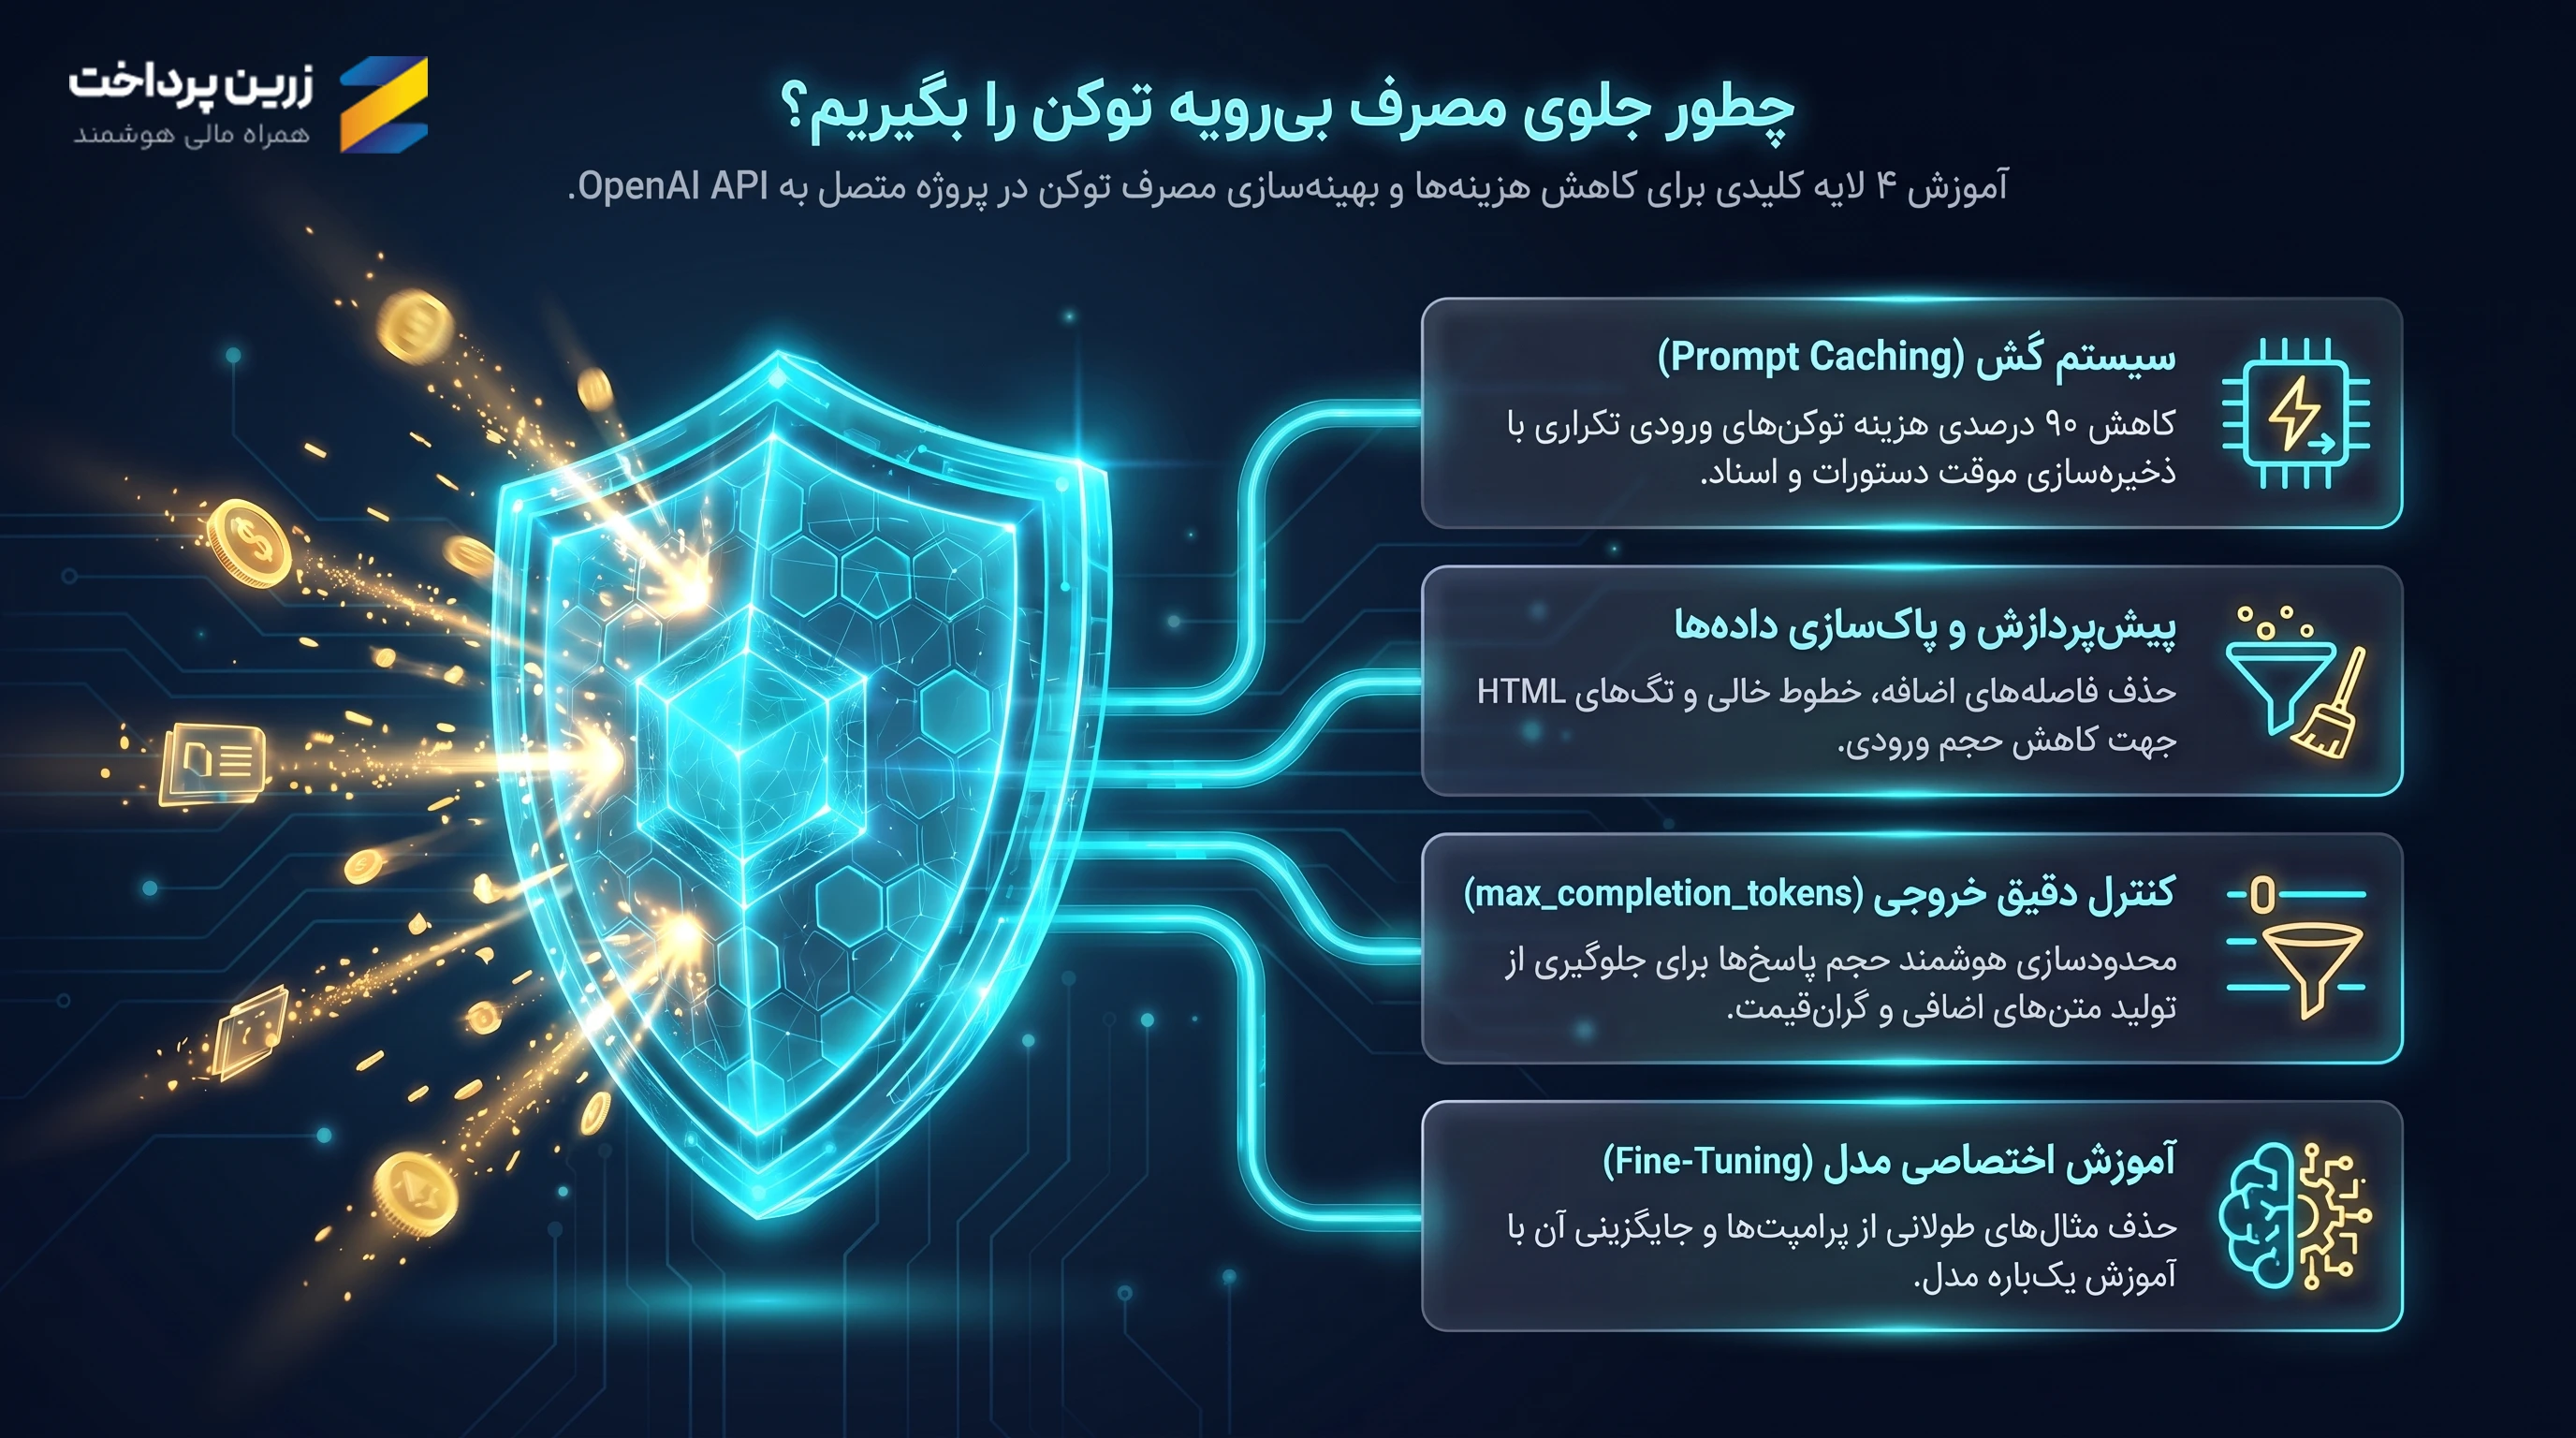
مدیریت هزینههای رابط برنامهنویسی صرفاً با انتخاب مدلهای اقتصادی تمام نمیشود؛ معماری درخواستها و نحوه ارسال دادهها به سرور، نقش اصلی را در هزینه نهایی بازی میکنند. با مهندسی دقیق پرامپتها و اصلاح ساختار کدها، میتوان جلوی پردازشهای اضافی را گرفت و هدررفت بودجه را در هر دو بخش ورودی و خروجی به حداقل رساند.
1. استفاده از سیستم کَش (Prompt Caching)
اگر دستورات سیستم (System Prompts)، اسناد مرجع یا دستورالعملهای طولانی را در ابتدای درخواستهای متوالی خود تکرار کنید، سرور آنها را در حافظه موقت نگه میدارد. این تکنیک هزینه توکنهای ورودی تکراری را دقیقاً 90 درصد کاهش میدهد و سرعت پاسخگویی مدل را به شدت بالا میبرد.
2. محدودسازی دقیق خروجی (max_completion_tokens)
توکنهای خروجی همیشه گرانترین بخش پردازش هستند.OpenAI توصیه میکند همیشه پارامتر محدودکننده خروجی (max_completion_tokens) را در کدهای خود تنظیم کنید. این پارامتر (که در مدلهای جدیدتر جایگزین max_tokens شده است) باعث میشود مدل پیش از تولید کلمات اضافه و غیرضروری متوقف شود و بودجه شما برای پاسخهای حاشیهای هدر نرود.
3. پیشپردازش و پاکسازی دادهها (Data Preprocessing)
قبل از ارسال هر متنی به رابط برنامهنویسی، باید تمام فاصلههای اضافه (Spaces)، خطوط خالی و به خصوص تگهای قالببندی (HTML) پاک شوند. کدهای اضافه و استایلهای بصری به شدت توکنخوار هستند. همچنین ارسال ساختارهای داده با فرمتهای فشرده (مانند مینیفای کردن کدهای JSON) حجم ورودی شما را به طرز چشمگیری کاهش میدهد.
4. آموزش مدل اختصاصی (Fine-Tuning)
اگر برای رسیدن به یک خروجی خاص، مجبورید در هر درخواست دهها مثالِ راهنما (Few-shot Prompting) به مدل بدهید، در حال هدر دادن توکنهای ورودی هستید. در پروژههای مقیاس بالا، بهتر است یک بار مدل پایه را با دادههای خود آموزش اختصاصی دهید. با این کار، نیاز به ارسال پرامپتهای طولانی در هر درخواست از بین میرود و سیستم با دریافت یک دستور کوتاه، خروجی دقیق و شخصیسازیشده تولید میکند.
جمعبندی
توکنها در رابط برنامهنویسی اپنایآی (OpenAI API)، صرفاً قطعات خردشده کلمات نیستند؛ بلکه واحد پولِ دنیای هوش مصنوعی و معیار اصلی سنجش توان پردازشی به شمار میروند.
در این بررسی دیدیم با وجود اینکه سیستم، کلمات فارسی را بیشتر از انگلیسی میشکند و به توکنهای ریزتری تبدیل میکند، اما ظهور معماریهای پیشرفته (مثل خانواده جیپیتی-6) باعث شده تا کفه هزینهها به نفع توسعهدهندگان برگردد.
از سمت دیگر، درک عمیق از ماهیت توکن به شما قدرت میدهد تا از سد محدودیتهای فنی مانند ظرفیت حافظه (Context Window) و سقف ترافیک (Rate Limits) عبور کنید. با شناخت این مفاهیم و بهکارگیری تکنیکهای بهینهسازی، میتوانید مصرف توکن در ChatGPT API را به شکل چشمگیری کاهش دهید.
اگر برای استفاده از سرویسهای OpenAI به اعتبار دلاری نیاز دارید، میتوانید از طریق زرینپرداخت در صفحه خرید اپن ای پی ای و شارژ OpenAI API حساب خود را شارژ کنید و بدون درگیر شدن با پرداختهای بینالمللی، اعتبار موردنیازتان را تأمین کنید.